
Come tradurre un video (audio e sottotitoli) con Claude Code o Codex
Uso principalmente l’IA per i miei progetti di traduzione. Su YouTube, TikTok o Facebook si trovano molti video cinesi che non offrono né sottotitoli automatici né traduzione automatica.
Dato che voglio capirli, ho creato un progetto in grado di automatizzare gran parte del processo: trascrivere il video, tradurre i sottotitoli e, se necessario, arrivare fino al doppiaggio automatico in francese.
Partendo dalla stessa base, è anche possibile creare automaticamente dei clipping, cioè brevi estratti del video.
In questo articolo prendo come esempio la traduzione cinese → francese. Ma il principio può essere adattato praticamente a tutte le lingue. Vi incoraggio vivamente a usare Claude Code o Codex CLI – da riga di comando.
Perché usare la trascrizione invece dell’OCR?
I video cinesi hanno spesso sottotitoli cinesi direttamente incastonati nell’immagine. Si potrebbe quindi usare l’OCR (riconoscimento del testo in un’immagine) per recuperare questi sottotitoli.
Dopo diversi tentativi, mi sono però reso conto che questo metodo era piuttosto lungo e complicato. Alla fine è più semplice partire direttamente dal parlato presente nel video e trasformarlo in testo grazie a un sistema di trascrizione automatica, chiamato ASR (Automatic Speech Recognition).
Il principio è quindi abbastanza semplice:
Video → trascrizione cinese → correzione → traduzione francese → sottotitoli francesi → eventualmente doppiaggio
Preparare la skill
Per automatizzare questo processo, consiglio di preparare in anticipo alcuni file di riferimento nella skill. Contengono le regole che gli agenti devono rispettare. Questo permette di modificare facilmente il comportamento del sistema senza dover riscrivere tutto il workflow.
references/
├── translation_rules.md   # regole di traduzione
├── glossary_zh_fr.md      # nomi propri e termini ricorrenti
├── formatting_rules.md    # regole di visualizzazione dei sottotitoli
└── quality_check.md       # controlli di qualità
Questi file possono essere preparati con l’aiuto dell’IA. Consiglio semplicemente di chiederle di proporre diverse varianti o alcuni esempi di traduzione, poi di scegliere il tono e le regole che vi si addicono.
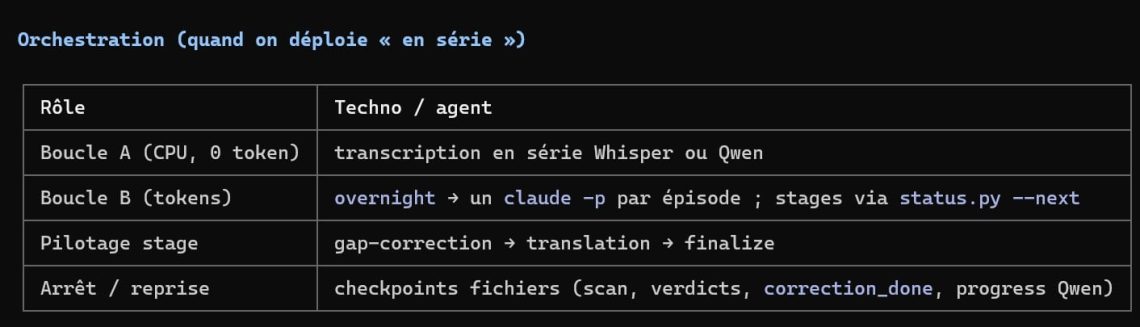
Per evitare di sovraccaricare la sessione principale con il testo dell’intero video, il workflow può poi utilizzare degli agenti autonomi. Ogni agente riceve solo le informazioni e i file di riferimento di cui ha bisogno. Ad esempio, un agente può occuparsi della trascrizione, un altro della traduzione e un altro ancora del controllo qualità. La sessione principale serve soprattutto a orchestrare le diverse fasi.
Il processo completo
1. Trasformare il parlato cinese in sottotitoli
Si comincia recuperando il video originale. Per YouTube, Facebook o TikTok, si può usare yt-dlp.
Si utilizza poi un sistema di riconoscimento vocale (ASR) per trasformare il parlato cinese in testo. Il risultato è un file di sottotitoli .srt contenente il testo cinese e gli orari di inizio e fine di ogni segmento.
Si può in particolare usare:
- faster-whisper (medium)
- Qwen3-ASR ForcedAligner
Per il cinese, preferisco Qwen3-ASR. In particolare, permette di fornire del contesto prima della trascrizione, il che può aiutare il modello a scegliere il carattere giusto quando più parole si pronunciano allo stesso modo.
Se in seguito prevedete di fare del doppiaggio o dei clipping, attivate anche l’allineamento temporale a livello di parola. Otterrete così un allineamento molto più preciso tra testo e voce.
2. Recuperare i passaggi che non sono stati trascritti
Una trascrizione automatica non è sempre perfetta. La presenza di musica, ad esempio, può disturbare l’ASR. Il sistema può talvolta considerare un passaggio come musica o canto e non trascrivere correttamente il parlato.
Per individuare questi problemi, si possono cercare nel file SRT i vuoti anormalmente lunghi tra due sottotitoli.
Per ogni passaggio mancante:
- si recupera il passaggio corrispondente con ffmpeg ;
- lo si riascolta;
- si rilancia una trascrizione solo su quel passaggio.
Questo permette di completare la trascrizione senza dover rielaborare tutto il video.
3. Correggere la trascrizione cinese
L’ASR può fare errori, in particolare con gli omofoni : il modello riconosce correttamente il suono, ma sceglie il carattere o la parola cinese sbagliata.
Si rileggono quindi i passaggi sospetti e si corregge la trascrizione prima di iniziare la traduzione.
Una cattiva trascrizione porta generalmente a una cattiva traduzione. Questa fase merita quindi un’attenzione particolare.
4. Tradurre dal cinese al francese
Una volta corretta la trascrizione cinese, questa viene suddivisa in segmenti. I segmenti vengono poi elaborati da un agente autonomo specializzato nella traduzione.
L’agente consulta in particolare i file di riferimento dello skill per rispettare le regole definite in anticipo:
- livello di lingua e registro;
- francese naturale piuttosto che traduzione parola per parola;
- traduzione dei nomi propri;
- termini ricorrenti del glossario;
- regole specifiche per i dialoghi.
Le traduzioni vengono poi assemblate conservando gli allineamenti temporali del file cinese. Per i video lunghi, è preferibile lavorare un segmento alla volta. Gli agenti autonomi possono così elaborare il testo senza saturare il contesto della sessione principale.
5. Verificare e ripulire la traduzione
Una volta completata la traduzione, si effettuano diversi controlli automatici:
- nessun carattere cinese deve rimanere nel file francese;
- il formato SRT deve essere valido;
- gli orari devono essere coerenti;
- il registro deve rimanere omogeneo;
- la traduzione deve rimanere coerente dall’inizio alla fine.
Un altro agente può poi effettuare una rilettura critica cinese ↔ francese. Il suo ruolo è cercare i controsensi, le omissioni e le traduzioni che cambiano il senso originale. Questa verifica è particolarmente utile quando la traduzione è stata realizzata segmento per segmento: permette di assicurarsi che l’insieme resti coerente.
Infine, si preparano i sottotitoli per la loro visualizzazione sullo schermo:
- si suddivide il testo in punti naturali;
- si distribuisce il testo su una o due righe;
- si verifica la lunghezza e la leggibilità;
- ci si assicura che nessuna parola sia andata persa.
Il file cinese originale viene conservato come riferimento per poter confrontare le due versioni.
6. Il risultato finale
Il risultato principale è un file:
video.fr.srt
Contiene i sottotitoli francesi con i loro orari.
A partire da questo file, si può poi:
- incidere i sottotitoli francesi nel video con ffmpeg;
- generare una versione doppiata in francese (text-to-speech, con le voci gratuite di Edge o Mac);
- creare automaticamente dei clippings o estratti video a partire dai sottotitoli e dai loro timestamp.
In sintesi
Il workflow completo può essere riassunto così:
Video cinese → trascrizione → correzione → traduzione → controllo qualità → sottotitoli francesi → doppiaggio / clippings
L’interesse di questa organizzazione è di separare chiaramente le diverse attività e di lasciare che gli agenti autonomi elaborino le parti più voluminose. La sessione principale resta così leggera e si concentra sull’orchestrazione del workflow.
